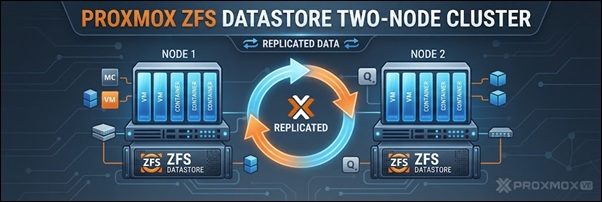
Poiché un datastore ZFS in un cluster Proxmox a due nodi opera localmente anziché come un pool di storage condiviso, è necessaria la replica Pool ZFS per sincronizzare i dati tra i nodi.
Per proteggere le macchine virtuali in esecuzione da guasti hardware imprevisti, l'implementazione della replica Pool ZFS automatica è la chiave per mantenere operativo il proprio business.
Creare il datastore ZFS
Per procedere con la creazione del datastore ZFS, verificare di disporre di un cluster Proxmox a due nodi configurato.
Poiché ZFS è un file system locale in cui più nodi non possono scrivere sullo stesso Pool ZFS contemporaneamente, a differenza di una SAN condivisa o di un cluster Ceph, Proxmox utilizza la replica incrementale per sincronizzare i dati di macchine virtuali e container tra nodi separati.
Il motore di replica integrato nella GUI di Proxmox opera rigorosamente per singolo guest (VM o Container) anziché a livello dell'intero pool. Questo significa che ogni volta che viene creata una nuova VM, è necessario aggiungere manualmente un job di replica dedicato.

Creare il datastore ZFS sul Node 1
Accedere al proprio cluster Proxmox e selezionare il Nodo 1. Posizionarsi nella sezione Disks per verificare che i dischi che si intende utilizzare per il Pool ZFS vengano rilevati.

Accedere alla sezione ZFS e cliccare Create ZFS.

Inserire un Name per il datastore, verificare che l'opzione Add Storage sia selezionata e scegliere il RAID Level desiderato. In questo esempio viene scelta l'opzione Single Disk poiché verrà utilizzato un solo disco. Selezionare il disco e cliccare su Create.

Una volta creato, il datastore ZFS verrà visualizzato anche tra le risorse disponibili nel nodo selezionato.

Creare il datastore ZFS nel Node 2
Selezionare Node 2 > ZFS e cliccare su Create ZFS.

Inserire esattamente lo stesso Name assegnato al datastore sul Nodo 1, deselezionare Add Storage e scegliew il RAID Level richiesto (Single Disk nell'esempio). Selezionare il disco da utilizzare e cliccare su Create.

Il datastore ZFS è stato ora creato ma non è ancora elencato come risorsa disponibile sul Nodo 2.

Andare su Datacenter > Storage e selezionare il datastore ZFS appena creato. Cliccare Edit.

Dal menu a tendina Nodes, selezionare il Node 2 e cliccare OK.

Il datastore ZFS è ora disponibile anche per il Node 2.

Per verificare i pool, aprire la Shell del Node 1 e controllare i Pool ZFS disponibili.
# zpool list

Effettuare la stessa verifica per il Node 2.
# zpool list

Creare la replica Pool ZFS
Per configurare la replica Pool ZFS, creare una nuova macchina virtuale e selezionare il datastore ZFS come Storage di destinazione.

Per assicurarsi che i dati siano disponibili su entrambi i nodi in caso di guasto di un nodo, bisogna configurare la replica. Andare su Datacenter > Replication > Add.

Nel campo CT/VM ID inserire l'ID della VM o del container che si desidera replicare. Specificare il nodo Target e la Schedule desiderata (ogni 15 minuti nell'esempio). Cliccare su Create.

Il job di replica è stato creato.

Fino a quando il job di replica non viene eseguito per la prima volta, il nodo di destinazione mostrerà il disco della VM con una dimensione di 0 byte.

All'orario pianificato, la replica viene eseguita e i dati del disco vengono copiati in modo sicuro sul nodo di destinazione.

Dopo la sincronizzazione iniziale, Proxmox copierà solo le modifiche incrementali (delta) durante ogni successiva esecuzione della replica.
Testare un guasto di un nodo
Se il nodo su cui è in esecuzione la VM si guasta (il Nodo 1 nell'esempio) e si sta utilizzando solo la replica Pool ZFS di base senza che Proxmox HA sia configurato, la VM non si avvierà automaticamente sul Nodo 2. Rimarrà offline poiché il Nodo 1 detiene solo un disco replica passivo.
Per automatizzare il processo di boot, bisogna configurare l'HA per la VM protetta. Selezionare Datacenter > HA e cliccare Add.

Seleziona la VM che si desidera proteggere e cliccare Add.

L'HA per la VM selezionata è ora abilitata.

Guasto del Nodo
Il Node 1 subisce un'interruzione di corrente improvvisa.

Quando l'HA viene attivata dal cluster, la VM viene spostata sul Node 2 e avviata automaticamente.

Quando il Node 1 torna online, la VM viene rimigrata in base alle impostazioni HA (l'opzione di Failback è abilitata).

La VM è ora nuovamente in esecuzione sul Node 1.

Da tenere presente che configurata la replica Pool ZFS, in caso di guasto di un nodo e di avvio della VM sul nodo secondario, tutti i dati scritti all'interno della VM tra l'ultima replica del Pool ZFS completata e il momento del guasto del nodo andranno persi.